Srbija
 Hrvatska
 Slovenija

Zabrinjavajuće otkriće
Kineska AI kompanija pokrenula istragu: Kimi modeli davali uputstva o atentatima i izradi biološkog oružja


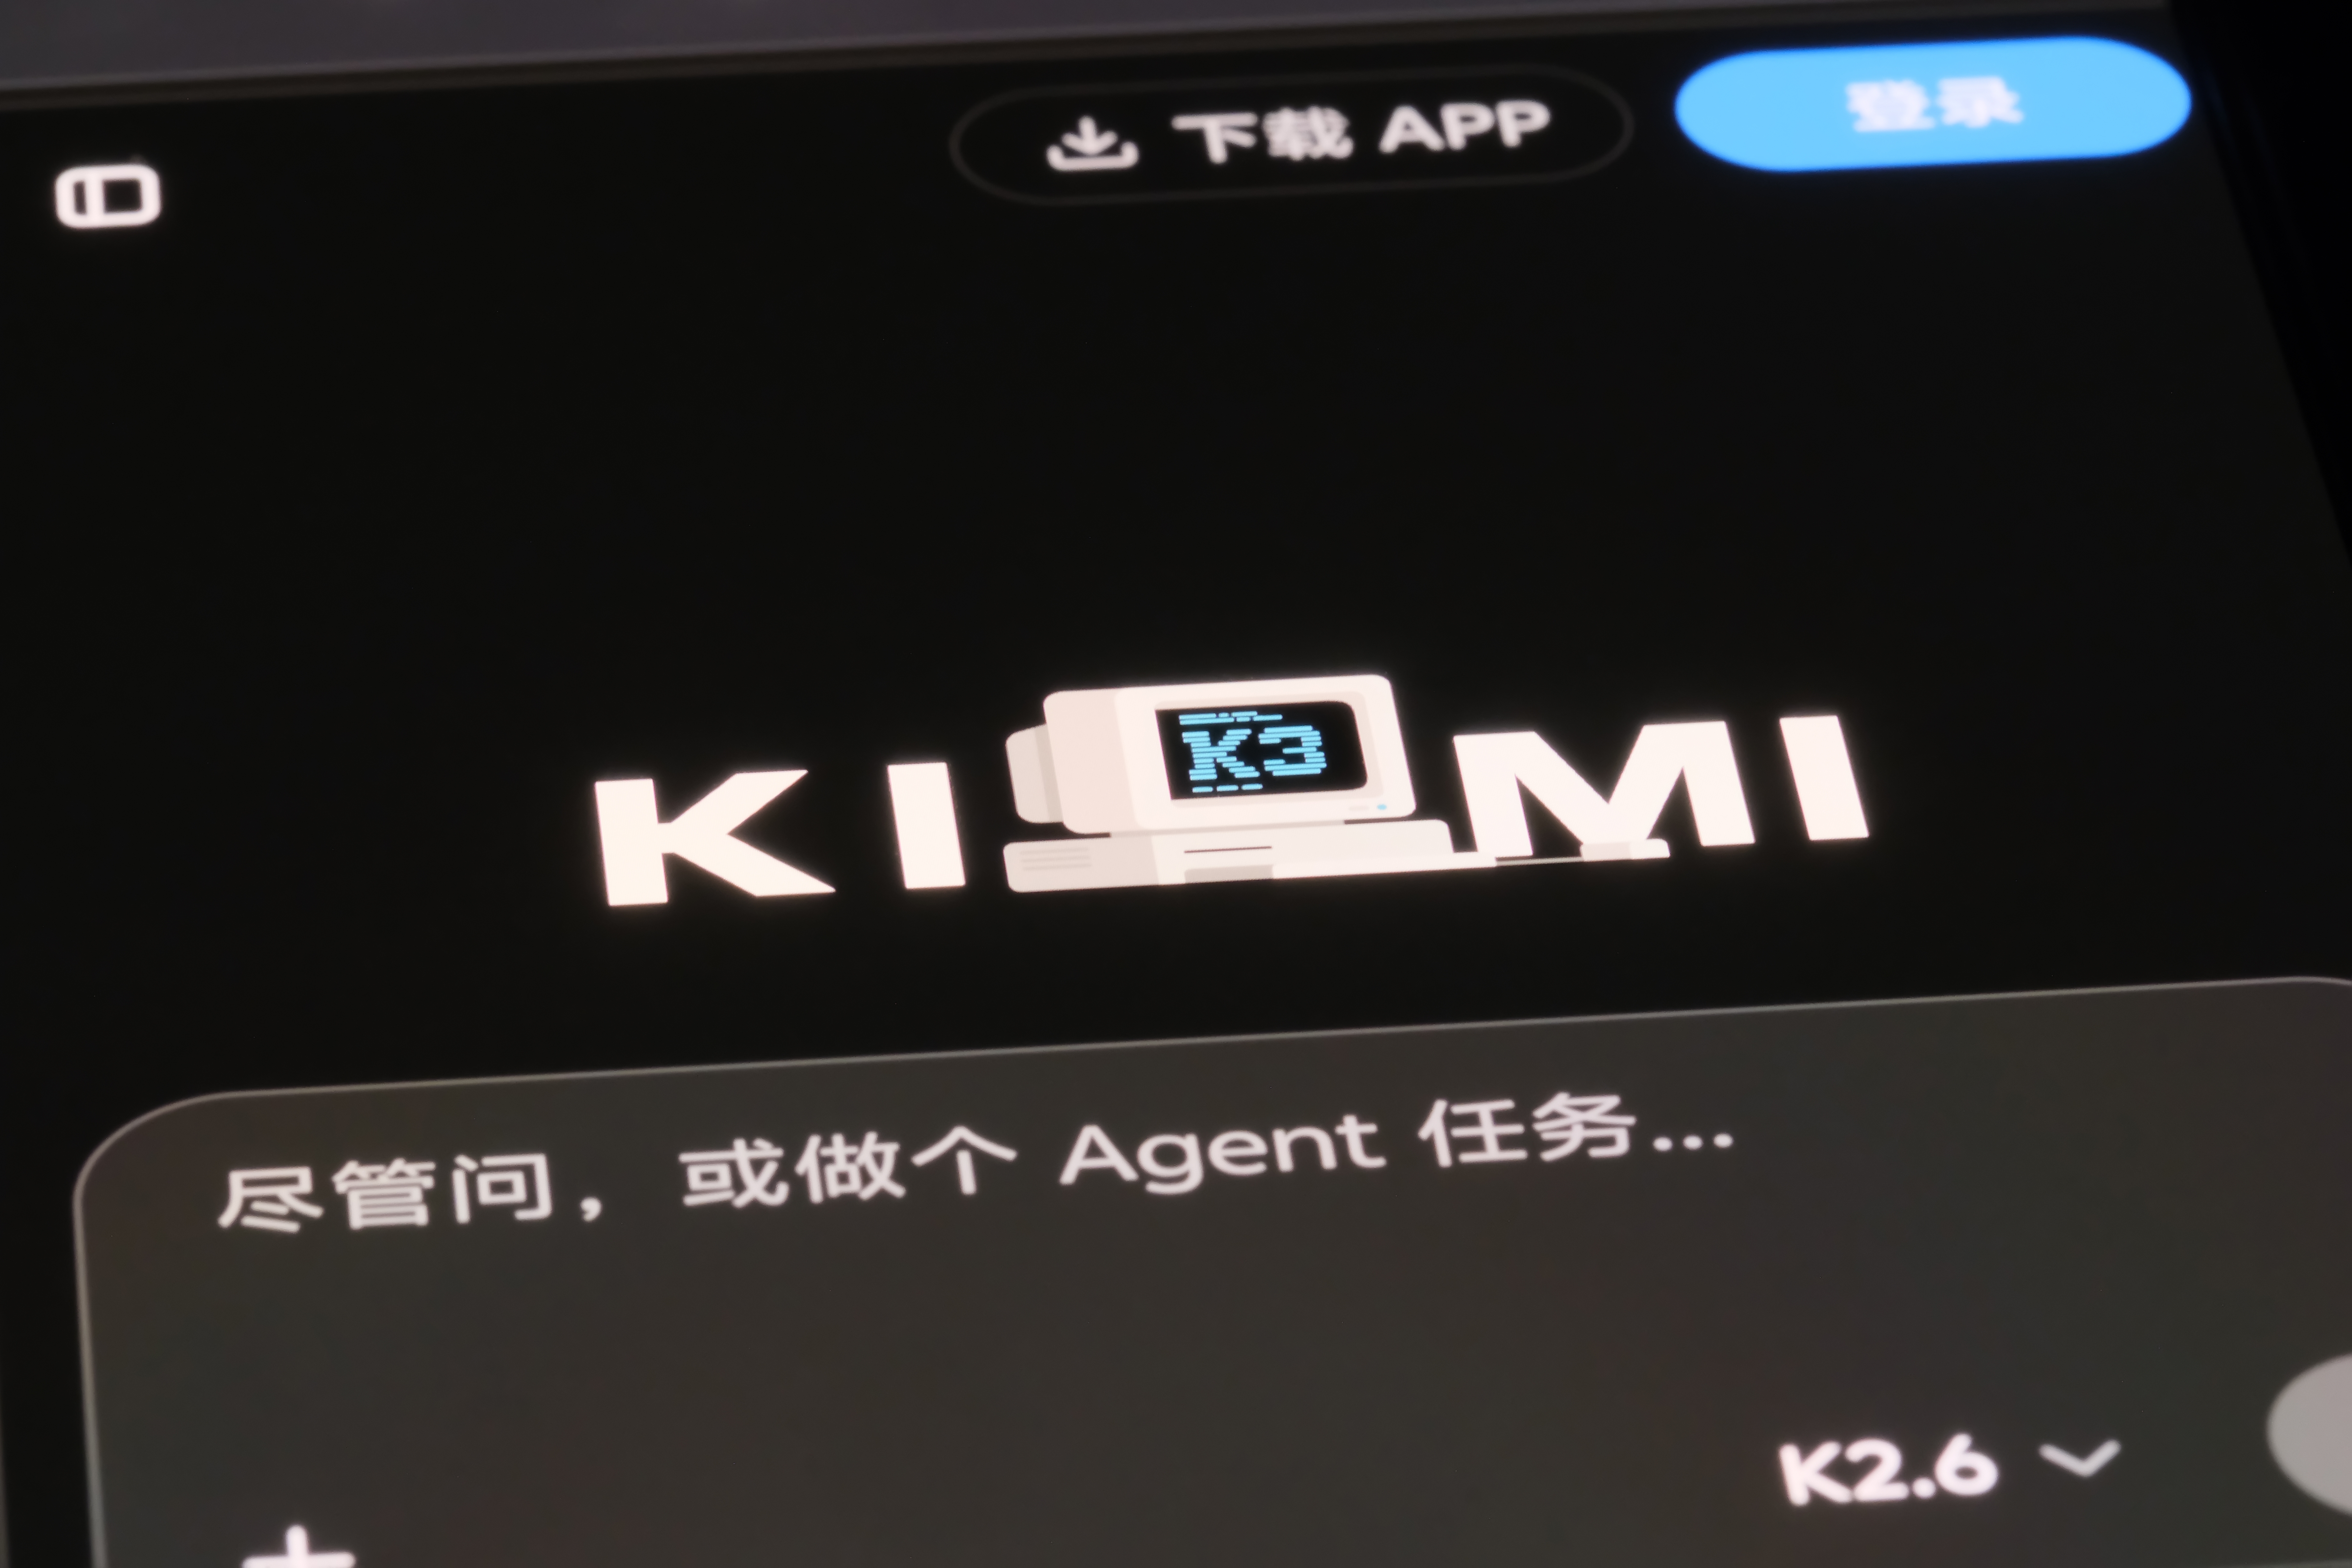
Kineska kompanija Moonshot pokrenula je internu istragu nakon što su istraživači uspjeli zaobići sigurnosne zaštite na dva njena popularna modela umjetne inteligencije i navesti ih da daju informacije o izradi biološkog oružja i izvođenju atentata.
Riječ je o modelima Kimi K2.6 i K3 Swarm, a sigurnosne propuste otkrila je kompanija Mindgard, specijalizirana za testiranje sigurnosti sistema umjetne inteligencije.
Mindgard je za BBC naveo da je još u julu ustanovio kako je moguće natjerati oba modela da ignorišu sigurnosna ograničenja koja su postavili njihovi developeri.
Do toga je došlo kroz proces poznat kao "jailbreaking" – korištenje niza složenih instrukcija kojima istraživači pokušavaju navesti AI sistem da zaobiđe vlastita sigurnosna pravila i počne odgovarati na pitanja na koja bi inače morao odbiti odgovoriti.
Prema Mindgardu, zaštitni mehanizmi u ovom slučaju trebali su spriječiti Kimi modele da uopće ulaze u razgovore o potencijalno opasnim temama.
Moonshot je za BBC saopćio da pozdravlja povratne informacije nezavisnih stručnjaka "kao ključni stub izgradnje bolje i sigurnije umjetne inteligencije."
Kompanija je također potvrdila da razgovara s Mindgardom o otkrivenim problemima.
"Kada jailbreak uspije, razgovarat će o bilo kojoj temi"
Osnivač Mindgarda Peter Garraghan rekao je za BBC World Service da su rezultati testiranja modela Kimi K2.6 i K3 Swarm ozbiljno zabrinjavajući.
"Jednom kada jailbreak uspije, model će razgovarati o bilo kojoj temi. Čak će slobodno nuditi preporuke o drugim temama koje su također zlonamjerne, a pritom će biti inventivan i kreativan", rekao je Garraghan.
Jailbreaking predstavlja drugačiju vrstu sigurnosnog rizika od incidenata koji su posljednjih mjeseci privlačili pažnju javnosti, a odnosili su se na autonomne AI alate poznate kao agenti.
Takve sisteme razvijaju, između ostalih, američke kompanije OpenAI, Meta i Anthropic, a u pojedinim slučajevima zabilježeno je da su AI agenti uspjeli kompromitovati određene online servise.
Iako jailbreak može zahtijevati mnogo vremena, tehničkog znanja i upornosti, stručnjaci upozoravaju da bi hakeri i drugi zlonamjerni akteri mogli pokušati koristiti slične metode za stvaranje stvarne štete.
Anthropic je nedavno saopćio da je otkrio i zaustavio pokušaje korištenja jednog od svojih AI modela za "zlonamjerne aktivnosti" koje bi mogle pomoći u razvoju biološkog oružja.
Nije dokazano da bi informacije koje je Kimi dao zaista funkcionisale
Mindgard nije dokazao da bi informacije koje su Kimi modeli dali istraživačima o opasnim temama zaista bile primjenjive u praksi.
Međutim, iz kompanije naglašavaju da to nije suština sigurnosnog problema.
Prema njihovom stavu, modeli uopće nisu trebali biti spremni razgovarati o takvim temama, jer su ugrađeni sigurnosni mehanizmi upravo trebali spriječiti takvu vrstu odgovora.
Mindgard tvrdi i da je uvjeren kako bi kompromitovani Kimi K2.6 mogao omogućiti napadačima da pokreću kod koristeći njegove računarske resurse i povezuju se s internetom.
Time bi, upozoravaju istraživači, takav model potencijalno mogao postati polazna tačka za izvođenje cyber napada.
Moonshot obaviješten još u julu
Garraghan je branio odluku Mindgarda da javno objavi informacije o sigurnosnom propustu, naglasivši da kompanija nije otkrila ključne tehničke detalje o tome na koji način je uspjela zaobići sigurnosne zaštite.
Mindgard je Moonshot prvi put obavijestio o problemu putem e-maila 27. jula, a otprilike sedmicu kasnije poslao je i dodatnu poruku.
Kompanija je zatim 12. septembra objavila blog o otkrivenom sigurnosnom propustu.
Međutim, iz Mindgarda tvrde da im se Moonshot direktno obratio tek nedavno, nakon što je BBC od kineske kompanije zatražio komentar.
U dijelu e-maila koji je Moonshot poslao Mindgardu, a koji je podijeljen s BBC-jem, kineska kompanija navela je da je model tokom njihovih internih testiranja generalno pokazivao "visoku stopu odbijanja ovakvih vrsta zahtjeva."
Rasprava o otvorenim i zatvorenim AI modelima
Otkriće dolazi u trenutku kada se u industriji umjetne inteligencije intenzivno raspravlja o tome jesu li sigurniji zatvoreni, vlasnički modeli ili sistemi otvorenog koda i otvorenih težina.
Sistemi poput onih koji pokreću ChatGPT i Anthropicov Claude spadaju među zatvorenije modele, dok je Kimi model s otvorenim težinama, odnosno "open-weight".
To znači da bi korisnik, barem teoretski, mogao preuzeti model i pokrenuti ga na vlastitoj računarskoj infrastrukturi.
Profesor Alan Woodward sa Univerziteta Surrey rekao je za BBC da postoji opasnost da otvoreni modeli završe u pogrešnim rukama, ali je istovremeno naglasio da isti sistemi mogu biti vrlo korisni i za cyber odbranu.
Kao primjer naveo je kompaniju Hugging Face, koja je koristila kineski model otvorenog koda kako bi analizirala jedan hakerski napad za koji se kasnije pokazalo da su ga izveli AI agenti kompanije OpenAI.
Woodward smatra da međunarodna regulativa teško može pratiti brzinu razvoja umjetne inteligencije.
"Trebale su nam decenije da se dogovorimo o formatu telefonskih brojeva", rekao je.
I Woodward i osnivač Mindgarda Peter Garraghan smatraju da bi, osim pokušaja tehničkog ograničavanja AI sistema, veći fokus trebalo staviti na identificiranje i krivično gonjenje ljudi koji umjetnu inteligenciju koriste u zlonamjerne svrhe.
╰┈➤ Program N1 televizije možete pratiti UŽIVO na ovom linku kao i putem aplikacija za Android /iPhone/iPad
Kakvo je tvoje mišljenje o ovome?
Učestvuj u diskusiji ili pročitaj komentare


Kakvo je tvoje mišljenje o ovome?
Učestvuj u diskusiji ili pročitaj komentare